사용자 수에 따른 규모 확장성
가상면접 사례로 배우는 시스템 설계 기초 1권
단일서버
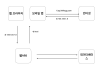
![]() 요청 처리 과정을 정리해보자
- 사용자는 도메인이름 (api.kkforgg.com)을 이용하여 웹사이트에 접속한다. 이 접속을 위해서 도메인 이름을 도메인 이름 서비스(Domain Name Service, DNS)에 질의하여 IP주소로 변환하는 과정이 필요하다. DNS는 제3 사업자(third party)가 제공하는 유료 서비스를 이용하게 되므로, 우리 시스템의 일부는 아니다.
- DNS 조회 결과로 IP 주소가 반환된다. 웹 서버 주소이다.
- 해당 IP 주소로 HTTP(HyperText Transfer Protocol) 요청이 전달된다.
- 요청을 받은 웹 서버는 HTML 페이지나 JSON 형태의 응답을 반환한다.
이 요청들은 두 가지 종류의 단말로부터 오는데, 하나는 웹 앱이고, 다른 하나는 모바일 앱이다.
웹 애플리케이션
비즈니스 로직, 데이터 저장 등을 처리하기 위해서는 서버 구현용 언어(자바, 파이썬 등)를 사용하고, 프레젠테이션용으로는 클아이언트 구현용 언어(HTML, 자바스크립트 등)을 사용한다.
모바일 앱
모바일 앱과 웹 서버 . 간통신을 위해서는 HTTP 프로토콜을 이용한다. HTTP 프로토콜을 통해서 반환될 응답 데이터의 포맷으로는 보통 JSON(JavaScript Object Notation)이 그 간결함 덕에 널리 쓰인다.
데이터베이스
사용자가 늘면 서버 하나로는 충분하지 않아서 여러 서버를 두어야 하는데, 하나는 웹/모바일 트래픽 처리 용도이고, 다른 하나는 데이터베이스용이다.
 데이터베이스의 종류
- 관계형 데이터 베이스: RDBMS라고 불리우고, 가장 유명한 것으로는 MySQL, Oracle, PostgreSQL 등이 있다.
관계형 데이터 베이스는 자료를 테이블과 열, 칼럼으로 표현한다. SQL을 사용하면 여러 테이블에 있는 데이터를 관계에 맞게 조인(Join)하여 합칠 수 있다.
- 비 관계형 데이터베이스 : NoSQL이라고 부른다. 대표적인 것으로는 CouchDB, Neo4j, Cassandra, HBase, Amazon DynamoDB등이 있다.
비 관계형 데이터베이스는 네 부류로 나눌 수 있다.
키-값 저장소(key-value store), 그래프 저장소(graph store), 칼럼 저장소(column store), 그리고 문서 저장소(document store)
- 비 관계형 데이터베이스는 조인 연산을 지원하지 않는다.
- 비 관계형 데이터베이스의 조건
아주 낮은 응답 지연시간(latency)이 요구됨
- 다루는 데이터가 비정형(unstructured)이라 관계형 데이터가 아님
- 데이터(JSON, YAML, XML 등)를 직렬화하거나(serialize) 역직렬화(deserialize) 할 수있기만 하면 됨
- 아주 많은 양의 데이터를 저장할 필요가 있음
수직적 규모 확장(Scale up), 수평적 규모 확장(Scale out)
- 수직적 규모 확장은 한계가 있다. 한 대의 서버에 CPU나 메모리를 무한대로 증설할 방법은 없다.
- 수직적 규모 확장법은 장애에 대한 자동복구(failover)방안이나 다중화(redundancy) 방안을 제시하지 않는다. 서버 장애가 발생하면 웹사이트/앱은 완전히 중단된다.
이런 이유로, 대규모 애플리케이션을 지원하는 데는 수평적 규모 확장법이 보다 적절하다.
로드밸런서
로드밸런서는 부하 분산 집합(load balancing set)에 속한 웹 서버들에게 트래픽 부하를 고르게 분산하는 역할을 한다.
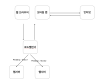 - 사용자는 로드밸런서의 공개 주소(public IP address)로 접근한다.
- 웹 서버는 클라이언트의 접속을 직접 처리하지 않는다.
- 보안을 위해, 서버간 통신에는 사설 IP(private IP address)를 사용한다.
사설 IP 주소는 같은 네트워크에 속한 서버 사이의 통신에만 쓰일 수 있는 IP 주소로, 인터넷을 통해서는 접속할 수 없다.
- 로드 밸런서는 웹 서버와 통신하기 위해 사설 IP주소를 이용한다.
로드밸런서에 접근 가능한 웹서버를 2개 이상 구성할 경우 1대의 웹 서버가 다운되더라도, 나머지 웹 서버를 이용하여 장애를 방지할 수 있다. 즉 가용성(avaliability)이 향상된다.
데이터베이스 다중화
많은 데이터베이스 관리 시스템이 다중화를 지원한다. 보통은 서버 사이에 주(master)-부(slave) 관계를 설정하고 데이터 원본은 주 서버에, 사본은 부 서버에 저장하는 방식이다.
쓰기 연산(write operation)은 마스터에서만 지원한다. 부 데이터베이스는 주 데이터베이스로부터 그 사본을 전달받으며, 읽기 연산 (read operation)만을 지원한다.
대부분의 애플리케이션은 읽기 연산 비중이 쓰기 연산보다 훨씬 높다.
따라서, 부 데이터베이스의 수가 주 데이터베이스 수보다 많다.
- 더 나은 성능
병렬로 처리될 수 있는 질의(query)의 수가 늘어나므로, 성능이 좋아진다.
- 안정성(reliability)
자연 재해 등의 이유로 데이터베이스 서버 가운데 일부가 파괴되어도 데이터는 보존될 것이다.
- 가용성(availability)
데이터를 여러 지역에 복제해 둠으로써, 하나의 데이터베이스 서버에 장애가 발생하더라도 다른 서버에 있는 데이터를 가져와 계속 서비스 할 수 있게된다.
캐시
캐시는 값비싼 연산 결과 또는 자주 참조되는 데이터를 메모리 안에 두고, 뒤이은 요청이 보다 빨리 처리될 수 있도록 하는 저장소이다.
예를 들어, 웹 페이지를 새로고침 할 때마다 표시할 데이터를 가져오기 위해 한 번 이상의 데이터베이스 호출이 발생한다. 애플리케이션의 성능은 데이터베이스를 얼마나 자주 호출하느냐에 크게 좌우되는데, 캐시는 그런 문제를 완화할 수 있다.
캐시 계층
캐시 계층(cache tier)은 데이터가 잠시 보관되는 곳으로 데이터베이스보다 훨씬 빠르다. 별도의 캐시 계층을 두면 성능이 개선될 뿐 아니라 데이터베이스의 부하를 줄일 수 있고, 캐시 계층의 규모를 독립적으로 확장시키는 것도 가능해진다.
캐시 사용시 유의할 점
- 캐시는 어떤 상황에 바람직한가?
데이터 갱신은 자주 일어나지 않지만 참조는 빈번하게 일어날 때 고려할 수 있다.
- 어떤 데이터를 캐시에 두어야 하는가?
캐시는 데이터를 휘발성 메모리에 두므로, 영속적으로 보관할 데이터를 캐시에 두는 것은 바람직하지 않다.
- 캐시에 보관된 데이터는 어떻게 만료(expire) 되는가?
만료된 데이터는 캐시에서 삭제되어야 한다. 만료 정책이 없으면 데이터는 캐시에 계속 남게 된다. 만료 기한은 너무 짧으면 곤란한데, 데이터베이스를 너무 자주 읽게 될 것이기 때문이다. 너무 길어도 곤란한데, 원본과 차이가 . 날가능성이 높아지기 때문이다.
- 일관성(consistency)은 어떻게 유지 되는가?
일관성은 데이터 저장소의 원본과 캐시 내의 사본이 같은지 여부이다.
- 장애에는 어떻게 대처할 것인가?
캐시 서버를 하나로 관리하는 것은 단일 장애 지점(Single Point of Failure, SPOF)이 될 수 있다. 따라서 여러 지역에 걸쳐 캐시 서버를 분산시켜야 한다.
- 캐시 메모리 크기는?
캐시 메모리가 너무 작으면 액세스 패턴에 따라 데이터가 너무 자주 캐시에서 밀려나서(eviction) 캐시 성능이 떨어지게 된다. 이를 막을 한 가지 방법은 캐시 메모리를 과할당(overprovision)하는 것이다. 이럴 경우 데이터가 순간적으로 증가하더라도 발생할 수 있는 문제를 예방할 수 있다.
- 데이터 방출(eviction) 정책은 무엇인가?
캐시가 꽉 차버리면 추가로 캐시에 데이터를 넣어야 할 경우 기존 데이터를 내보내야 한다. 가장 널리 쓰이는 것은 LRU(Least Recently Used - 마지막으로 사용된 지점이 가장 오래된 데이터를 내보내는 정책) 이다. 다른 정책으로는 LFU(Least Frequently Used - 사용된 빈도가 가장 낮은 데이터를 내보내는 정책), FIFO(First In First Out - 가장 먼저 캐시에 들어온 데이터를 가장 먼저 내보내는 정책) 같은 것도 있으니 경우에 맞게 사용하면 된다.
콘텐츠 전송 네트워크 (CDN)
CDN은 정적 콘텐츠 전송하는데 쓰이는, 지리적으로 분산된 서버의 네트워크이다. 이밎, 비디오, css, javascript 파일 등을 캐시할 수 있다.
CDN은 파일을 자체 캐싱해두기 때문에 응답속도를 개선할 수 있다.
제3 사업자에 의해 운영되다보니 비용문제가 클 수 있다. 비용에 대한 부분을 적절하게 확인하면 좋다. 자체 캐시를 사용하다보니 만료정책을 적정하게 세워야 한다.
CDN 장애 발생시 어떻게 처리할지 고민이 필요하다.
데이터 라우팅
지리적 라우팅(Geo-routing)
지리적 라우팅에서는 사용자의 위치에 따라 도메인 이름을 어떤 IP 주소로 변환할지 결정할 수 있도록 해주는 DNS 서비스다.
몇가지 해결해야할 점
- 트래픽 우회
올바른 데이터 센터로 트래픽을 보내는 방법
- 데이터 동기화
- 테스트와 배포(deployment)
웹 사이트 또는 애플리케이션 여러 위치에서 테스트 해보는 것이 중요 함
메시지큐
메시지 큐는 메시지의 무손실(durability, 즉 메시지 큐에 일단 보관된 메시지는 소비가자 꺼낼 때까지 안전히 보관된다는 특성)을 보장하는, 비동기 통신을 지원하는 컴포넌트이다.
메시지의 버퍼 역할을 하며, 비동기적으로 전송한다.
생산자또는 발행자(producer/publisher) 입력 서비스가 메시지를 만들어 메시지 큐에 발행한다. 소비자 혹은 구독자 (consumer/ subscriber) 서비스 혹은 서버가 연결되어 있는데, 메시지를 받아 그에 맞는 동작을 수행하는 역할을 한다.
메시지 큐를 이용하면 서비스 또는 서버 간 결합이 느슨해져서, 규모 확장성이 보장되어야 하는 안정적 애플리케이션을 구성하기 좋다.
로그, 메트릭 그리고 자동화
- 로그
에러 로그를 모니터링하는 것은 중요하다. 시스템의 오류와 문제들을 보다 쉽게 찾아낼 수 있도록하기 떄문이다. 로그를 단일 서비스로 모아주는 도구를 활용하면 더 편리하게 검색할 수 있다.
- 매트릭
메트릭을 잘 수집하면 사업 현황에 관한 유용한 정보를 얻을 수도 있고, 시스템의 현재 상태를 손쉽게 파악할 수 있다.
호스트 단위 메트릭 : CPU, 메모리, I/O에 관한 메트릭이 여기 해당한다.
- 종합(aggregated) 메트릭: 일별 능동 사용자(daily active user), 수익(revenue), 재방문(retention)같은 것이 여기 해당된다.
- 자동화
빌드, 테스트, 배포 등 절차를 자동화 할 수 있다. 이는 개발 생산성을 크게 향상 시킬 수 있다.
정리해보면
- 웹 계층은 무상태 계층으로
- 모든 계층에 다중화 도입
- 가능한 한 많은 데이터를 캐시할 것
- 여러 데이터 센터를 지원할 것
- 정적 콘텐츠는 CDN을 통해 서비스할 것
- 데이터 계층은 샤딩을 통해 그 규모를 확장할 것
- 시스템을 지속적으로 모니터링하고, 자동화 도구들을 활용할 것