ElasticSearch Basic
Introduce Elasticsearch
RESTful
“Near Real-Time” Search Engine
- 인덱싱한 데이터에 대한 검색이 실시간으로 가능하지는 않지만, 정해진 시간 안에 인덱싱이 완료되고 검색이 가능하다. ex)refresh_interval: 10s -> 인덱싱 후 10초 이내에 검색이 가능해짐
분산형 저장소
- 데이터의 분산 저장, 검색, 백업이 가능하다. 분산 저장과 노드 간 데이터 조정, 백업 복구 등은 자동으로 수행된다.
Near Real-Time Search Engine
Lucene의 segment처리 방법이 Realtime이 아니기 때문
RESTful API
Support various client, also easy to make your own
분산형 저장소
편리한 데이터 분산 저장과 복제
쉬운 노드 확장
장애 복구와 힐링 정책
Elasticsearch
Recent version : 8.3.1 (July 1, 2022)
License: Elastic License 2.0
Apache License 2.0에서 Elastic License로 전환(7.11버전 부터)
AWS와 법적 분쟁이 발생된 이후부터 OpenSource가 아니게 되었음.
ElasticSearch는 OpenSource가 아니다.
AWS에서는 7.11 version을 fork 해서 독자적으로 만들어나가고 있는데 이것이 OpenSearch이다.
Pricing
Basic(Free) License는 무료
AWS와 GCP로 호스팅 하는 Elastic Cloud
ELK : Elasticsearch, Logstash, Kibana
Beats, Logstash, Elasticsearch, Kibana
ELK 대신에 EFK가 있다.
fluentd는 logstash와 비슷하다.
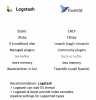 Logstash는 Buffer 기능이 없어서 traffic이 몰릴 경우 이슈가 있었는데, 최근에 buffer가 추가되고 있다.
Logstash는 JVM 위에서 동작할 수 있도록 JRuby로 작성되어 있어 메모리 사용량이 좀더 많다.
ex) audit beats 라는 plugin 형태로 제공해주는데, 사용하게 되면 자동으로 index 생성되고 audit 정보를 저장해준다.
Node
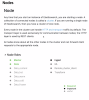 Coodination Node
 Master Node
실제로는 하나의 마스터가 요청을 전부 처리하지만, 최소 3개의 Master-eligible 노드를 살려두는 것이 좋다. 마스터가 모두 다운되면 복구될 때 까지 클러스터로 들어오는 모든 요청이 거부된다.
리소스에 여유가 있다면 마스터 노드를 다른 역할과 분리시키는 것이 좋다. 고부하 상황에서 Data, ingest가 OOM등의 이유로 고장을 일으키면 마스터가 영향을 받을 수 있기 때문.
Ingest Node
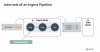
Logstash의 Ingest filter와 거의 동일하다. Ingest Node는 REST API로 입력된 데이터에 한해서 데이터 전처리를 수행할 수 있는 반면, Logstash는 다른 소스로부터 데이터를 뽑아내거나 버퍼를 두고 부하 상황을 조정할 수 있다.
 Data Node
얼마나 많은 리소스가 필요할까?
ES 클러스터를 구성할 때 메모리와 디스크가 클러스터 비용의 대부분을 차지한다. Elasticsearch는 JAVA로 작성되었기 때문에 JVM heap 영역을 최대 32GB 까지 설정할 수 있다. 그리고 Elasticsearch에서는 데이터 노드에서 heap 사용량에 따라서 하나의 Data 노드는 최대 64GB의 메모리가 권장 사양이며, 그 이상으로 메모리를 설정하는 것은 성능 증가 폭이 작다.
1개의 Data Node Resource Limit
- CPU : unlimited
- Memory : 64GB
- Disk: 1920GB
Memory는 JVM Heap을 32GB 까지 설정할 수 있지만 32GB로 설정하면 성능이 감소하는 문제가 있다. 이 때문에 Elastic Cloud를 비롯한 클라우드형 Elasticsearch와 VES에서도 힙 메모리는 31GB 이하로 설정하고 있다.
Elasticsearch에서는 Memory:Disk의 비율은 1:30 정도를 권장하고 있다.
디스크 사용량 관리 정책
low : 85%
더이상 index 생성이 불가.
high : 90%
shard를 옮기는 작업을 진행 함.
flood_stage : 95%
모든 index의 데이터 등록을 불가능하게 한다.
Data Structure