2019 NHN Forward 참가
Small Steps make a Big Difference
![]() 추천 시스템
추천시스템이란?
과거에는 주목받지 않음. 이후 발전되어가면서 다양한 상품들이 발생 때문에 이러한 상품을 구매할 때 결정이 오래 걸리게 됨. 따라서 과거에 구매 이력을 통해 추천시스템은 분석을 시작하고, 아이템을 추천하게 됨. (Feedback)
대표적인 케이스는 아마존이다. wish list나 구매 이력을 통하여 분석하고 추천해준다.
Netflix 도 비슷하다.
데이터가 많은 회사들에서만 도입하다가 이제 영세한 업체들도 도입하게 되었다.
content 기반
추천에 대상이 되는 content(상품에 대한 컨텐츠)에 대한 내용.
과거 이력등을 종합하여 사용자가 원하는 아이템을 식별할 수 있는 것이 만들어짐.
(본인의 데이터를 기반으로 활용함)
trust 기반
여러 사용자가 추천한 내용을 바탕으로 추천을 해줌
Collaborative filter (CF)추천 (협업 필터) 기반
- 이웃 찾기
나와 취향이 비슷한(이웃) 사용자가 공통적으로 좋아할만한, 본인만 구매하지 않은 목록들을 대상으로 추천.
- 평가하지 않은 아이템 ( 사용자가 찾아본적이 없는) 대하여 얼마나 좋아할 것인가 예측.
내가 모르는 상품을 얼마나 좋아할 것인가(선호도)에 대한 점수를 종합하여 계산, 예측을 함.
이중 Top k 위에 해당되는 상품을 보여줌.
Rating Matrix 를 만들어서 이 데이터를 기반으로 추천을 해줌.
추천 시스템의 발전은 아래와 같이 발전 되었다.
Maxtrix/Tensor Factorization -> Social Network Analysis -> Deep learning
최초 Deep learning 을 도입했을 때 데이터가 부족하여 결과가 좋지 않았다.
Exploiting Uninteresting Items for Effective Collaborative filtering
“내가 싫다고 했던거 보여주지 말라고 했잖어, 왜 또 보여줘?”
기존에는 구매했던 내용 대상으로만 점수를 계산하여 추천했었는데, 이런 방법이 아닌 싫어하는 상품을 제외? 하여 추천시킨다.
실제적으로 계산에 대상이 되는 데이터는 4% 미만이었다. 이것들로 평가하지 않는 아이템에 대한 계산하여 추측 하는 방법이 문제가 된다고 생각하여 발생하게 됨.
평가하지 않는 아이템 기준
- 존재 자체도 모르는 아이템
2. 존재는 알지만 내가 좋지 않아서 구매하지 않고, 점수를 주지 않음.
사용 전 선호도
사용자가 item을 구매하기 전에 평가.
사용 후 선호도
사용자가 item을 구매하고 나서 얻는 평가.
사용 전 선호도 평가 후 사용 후 선호도를 평가하지 않으면, 이건 좋아하지 않는 item 인지를 식별할 수 있도로 계산.
Zero-Injection (빵점 주기) 방식을 이용하여 기존에 값을 보정할 수 있다고 함.
장점.
-
기존에 CF 방법에 대한 정확도를 높일 수 있다.
-
사용자가 좋아하는 상품과, 좋아하지 않는 상품 두가지를 추천할 수 있다.
그리고 기존의 방법을 수용할 수 있다.
-> 기존 것을 그대로 남겨두고 보정만 실행할 수 있다.
2번째
워크 플로우
Git Flow
성공적인 git Branch 모델로 소개됨
항상 존재하는 브랜치
-
master
-
develop
서포팅 브랜치
-
병렬 업무 가능
-
필요할 때 생성, 역할을 완료하면 삭제
-
feature 브랜치
-
release 브랜치
-
hotfix 브랜치
release 브랜치를 생성할 때 사용하는 version을 기반으로 hotfix도 추가하여 생성한다.
ex) release : v1.0, **hotfix : v1.0.1 **
Github flow
git flow의 대부분 케이스가 너무 복잡하여 발생함.
github 플로우는 개발 철학을 설명하고 워크 플로우를 이해하기 쉽게되어 실수가 없어졌다고 함.
master branch
언제 배포해도 문제가 없어야 하며 새로 feature를 따도 문제가 없어야 한다.
빌드를 했을 때 실패하게 만드는 commit을 한다면 규칙에 위반된다.
topic branch
기능을 설명하는 명확한 이름으로 생성.
기능개발, pull Request 개설, 코드리뷰/논의, 배포 로 구분
완료된 topic branch를 배포할려고 하면 반드시 CI 빌드를 통과해야 한다.
이때 배포 lock을 걸 수 있는지 확인해야 한다.
master의 최신 내용이 topic 내용에 포함되어 있는지 확인한다.
Gitlab Flow
git flow, github flow 둘다 문제가 있다고 함.
gitlab flow는 여러가지 케이스에서의 모범 사례를 소개한다.
지속적인 배포가 어려울 때
존재하지 않는 이미지입니다.
환경별 배포가 필요할 때
존재하지 않는 이미지입니다.
릴리즈 소프트웨어 일 때
존재하지 않는 이미지입니다.
**이미지 출처 : ( **https://ujuc.github.io/2015/12/16/git-flow-github-flow-gitlab-flow/)
현재 사용중인 브랜치 전략.
개발일정 브랜치
- 배포 일자에 맞춰 develop 브랜치에 날짜를 명시해줌
코드네임 브랜치
- 장기간 개발을 해야되는 경우 코드 네임을 부여하여 진행 함.
릴리즈 브랜치를 생성하지 않음.
master로 merge 하면서 tag를 생성함.
jenkins + sonarQube등을 적극적으로 활용하여, 코드를 관리하고 있다.
각 workflow 들은 특정한 철학이 들어있다.
그 철학에 맞춰(회사 인원이나 성향 능력 등 고려) 방법을 선택하면 된다.
**3번째 **
응집력, 식별성, 속성
값 객체
Aggregate 루트를 바라보면서 연관 객체의 참조 형태를 바라보면, 어떻게 접근이 가능한지 알 수있다.
애그리게이트(aggregate) -> 스크럼 모델링의 핵심이 살아 있는 곳. 각 모델들은 별도의 패키지로 분리하여 관리한다. 일관성의 경계 (consistency boundary) 애그리게잇에서 영속성에 따라 가져오는 데이터량이 많다면 메모리 사용량도 고려해야한다. 하나의 트랜젝션 -> 일관성 경계 경계의 밖에선 결과적 일관성을 사용하라. -> transaction 범위를 벗어난 부분에서는 결과로 리턴된 객체를 이용하여 사용하라는 것 같음 애그리게잇에게 의존성 주입은 피하라. 도메인 객체에 식별 가능한 행위(메서드)로 표현한다.
분할정복이 핵심이다.
-> 분할정복이 핵심 객체의 일관성, 결합도, 복잡성을 분리하는 것이 DDD 의 분할정복이다? 흠..
Event 발행은 Trigger 를 직접 호출하지 않고 발행되는 것이 best다.
-> 명시적으로 발행하는 방법과 Spring Data에서 자동으로 발생되는 방법이 있다. @DomainEvents 애노테이션 등 이용.
@ApplicationService 확인해보자.
행위만 가지고 있는 것을 애플리케이션 서비스라고 한다.
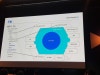 패키지를 설계할 때 헥사고날 아키텍처를 빗대어 구조를 설계했는데, 어느 정도 나에게 감명이 있는 거 같다.
내가 작성했던 코드와 패키지를 나누는 부분이 얼추 비슷하게 맞아 떨어지도록 한거 같다. 위의 모형이 좀더 잘 정리되고 내용에 맞춰져 있는거 같다.
4번째
 클라우드 환경으로 기존 서비스를 마이그레이션 하는 부분들에 대해서 실패/성공한 이야기를 공유.
이런 문제들을 풀어갈 때 문제는 사람 문제가 많지 않을까라고 생각한다.
-> 사람의 문제란 방어적이거나 소극적인 부분들을 말함.
기술은 많이 있다. 하지만 그 속에 비즈니스를 어떻게 나누고 적용할 것인가가 중요하다.
단위를 나누는 행위가 가장 어려운 부분이다.
Event Storming 을 하면서 MSA로 가보자. (이러한 행위를 “주인공 찾기” 라고 했다.)
-> 이 세션에서 말하는 것도 그냥 하나의 방법일 뿐이다.
TheOpenCloudEngine/uEngine-cloud
OCE’s main component includes : PaaS (Self-service) Portal, Dev-ops, Cloud orchestrator. Also includes microservices-architecture components: Identity & Access Management conforming to OAu…
핵심 도메인
도메인
지원 서브 도메인
일반 서브 도메인
형태로 나눌 수 있다.
이벤트 스토밍은 2시간 내에 거의 끝나고, 각 bounded context를 나누는 것이 완료라고 본다.
개발자와 비즈니스 관계자와 서로 동일하게 도메인에 대해 알 수 있다.
연간관계, 흐름관계 등
MSA를 도입하고자 이러한 행동을 하는 순간 부터 개발자 역시 개발만 하는 것이 아닌 비즈니스 쪽 까지 이해해가는 것이 필요하다.
해당 세미나에서 보여주는 패키지 구조는 앞에 DDD lite 세션과 패키지 구조가 다르다.
역시 딱 맞아 떨어지는 답은 없는거 같다. 좀더 어떤 부분으로서의 생각이나 해석의 정도에 따라서 변하는거 같다.
BoundedContext등 나누고 MSA 구조가 결정되고 나면, 배포 크기는 어떻게 나눌 것인지.
조직의 크기에 따라서 얼마 정도의 Domain을 할당 받아 처리할지등을 고려해야 한다.
ex) 발표자는 1개 조직에서 4~5개의 Micro Service를 운영할 수 있다고 생각한다고 했다.
그리고, MSA나 애자일등을 도입해서 개발할 때, 끝이 나지 않으면 문제가 있다. 이런 부분을 경계하라고 이야기 했다.
5번째
해당 발표자는 Java로 게임 서버 엔진을 만들라는 미션을 받아서 실시간 서버 엔진을 개발하였다.
동기화 처리 및 흐름제어 부분이 제일 어렵다.
-> 주니어 개발자들도 이런 동시성 문제로 인한 어려움 없이 할 수 있는 방법은 무엇일까?
- 싱글 Event Loop
-> 성능 이슈가 발생됨
이러한 비동기 처리 방식이 아닌 싱글 이벤트 루프를 이용하여 동기적으로 구조를 만들 수 있는 방법이 무엇일까 고민하던 중 fiber를 알게 되었다.
Thread
Fiber
선점형 멀티태스킹
협력적 멀티태스킹
동작중인 쓰레드가 스케줄러에 의해서 강제로 다른 스레드로 전환
다른 파이버로 전환되기 위해서 실행중인 파이버를 스스로가 멈춰야함.
context-switching이 kernel에서 발생
context-switching이 user-space에서 발생.
하나의 core에서 만드는 여러 Thread간에는 race condition이 있음
하나의 Thread에서 만드는 여러 Fiber 사이에는 race condition이 없음
하나의 스레드를 생성하는데 약 ~22MB 메로리 사용
하나의 파이버 생성하는데 약 400byte 메모리 사용 (Java 기준) 10000개의 fiber를 생성할 경우 = 약 4MB
Coroutine 이란
-
루틴의 로컬 상태를 유지하면서 제어를 반환했다가(suspend), 제어를 다시 확득(resume)흐름을 이어 갈 수 있는 제어 장치
-
제어 흐름에 관련된 용어 (if, else)
-
Function은 suspend(yield) / resume이 빠진것.
순차 처리 방식을 이런 코루틴을 이용하여 흐름을 제어가 가능하다고 이야기 함.
Generator란 무엇인가?
Loop의 반복 동작을 제어하는데 사용
기본적으로 Generator는 반복자
흐름 제어하는 측면에서 구현
javascript 코드로 표현하였다. yield 사용
Java는 이러한 Corutine에 대해 따로 제공해주는 기능이 없다. 따라서 그걸 지원해주도록 라이브러리가 있는데 그런 것이 Quasar라고 하였고, 그걸 사용했다고 한다.
단점은 다음과 같다.
- 현재는 버전 업이 안되고 있음.
6번째
쿠폰듀스X 101
: 가장 좋은 쿠폰을 픽하려다 만난 CPU full load 개선기
최적 선택 문제
assignment problem 관련 계산 식이 있음
헝가리안 알고리즘.
최소 매칭을 어떻게 하는 방법이 있는지에 대한 내용임.